面经-AI
SpringAI项目
大模型应用开发技术架构有几种?
目前,大模型应用开发的技术架构主要有四种:
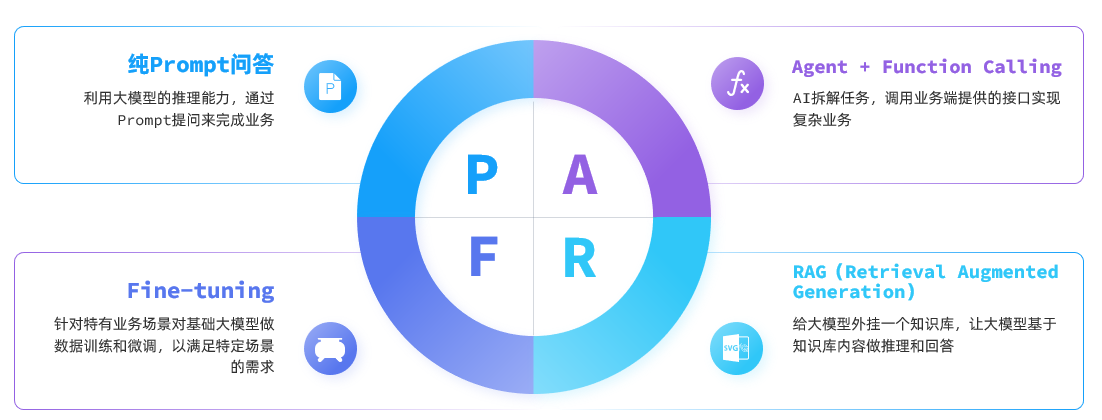
从开发成本由低到高来看,四种方案排序如下:
Prompt < Function Calling < RAG < Fine-tuning
Prompt
不同的提示词能够让大模型给出差异巨大的答案。不断雕琢提示词,使大模型能给出最理想的答案,这个过程就叫做提示词工程(Prompt Engineering)。
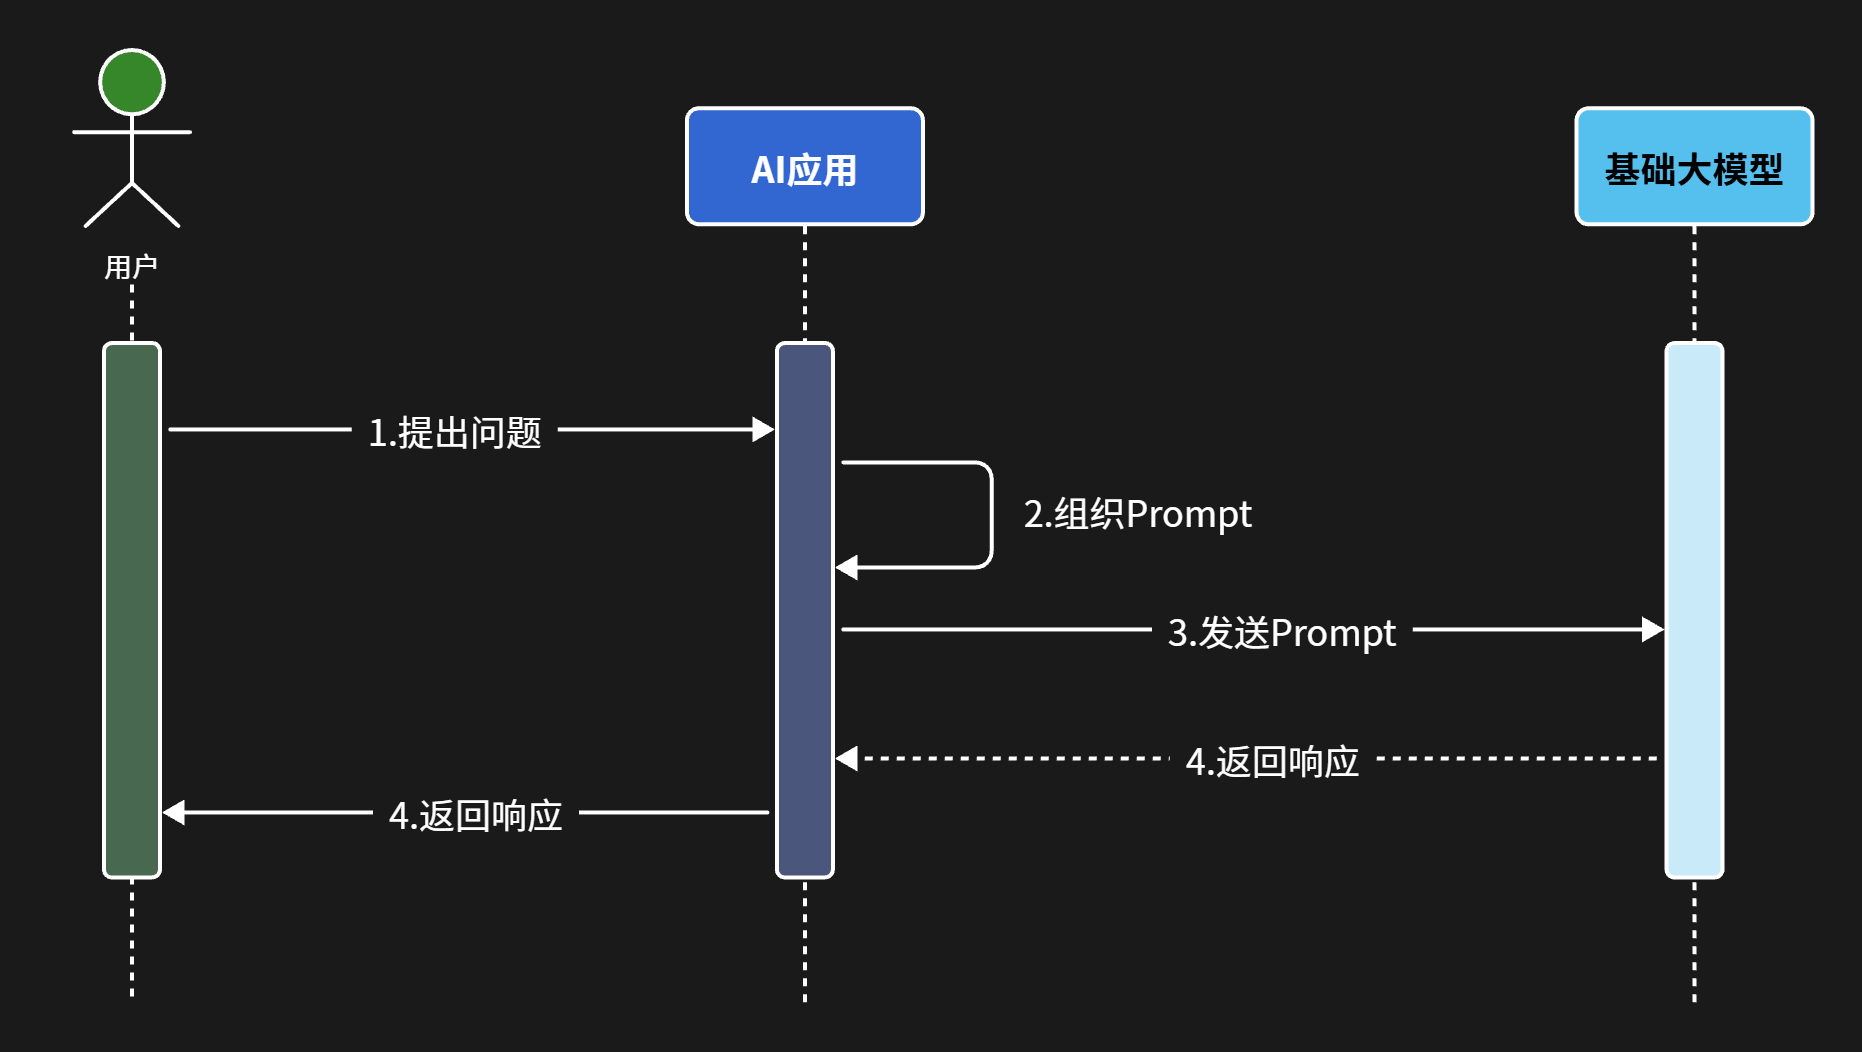
很多简单的AI应用,仅仅靠一段足够好的提示词就能实现了,这就是纯Prompt模式。
其流程如图:
Function Calling
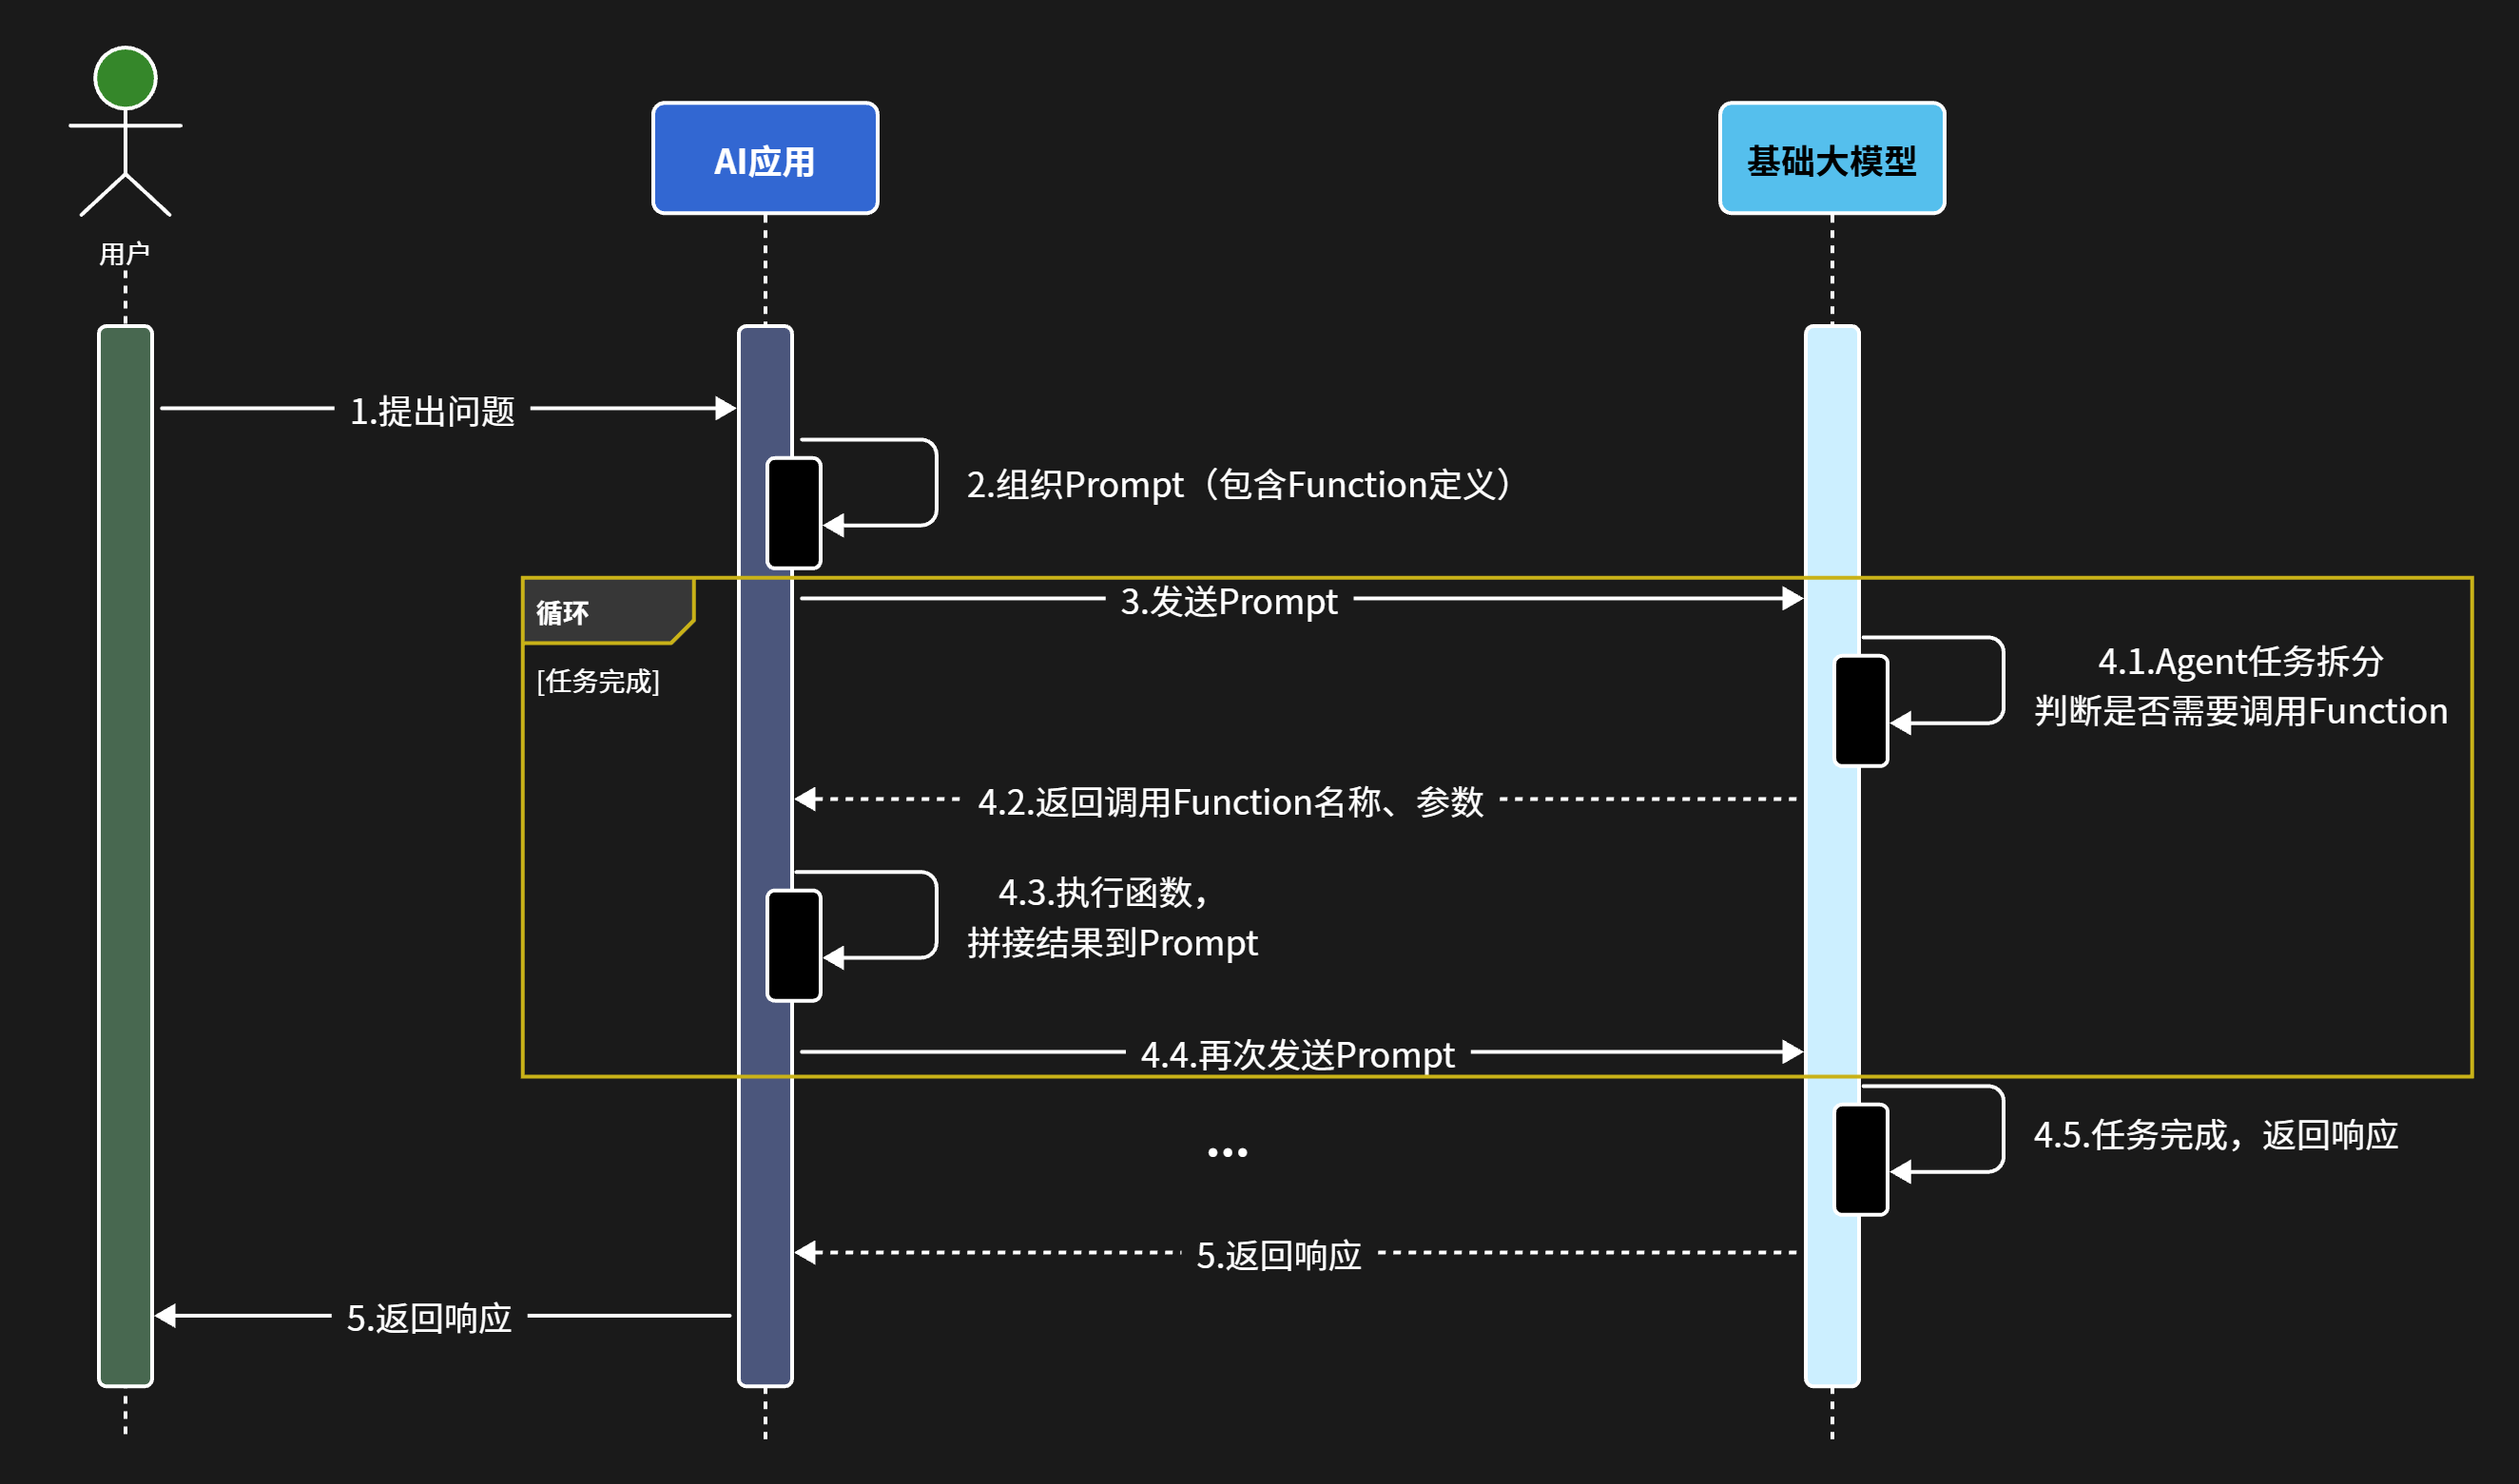
大模型虽然可以理解自然语言,更清晰弄懂用户意图,但是却无法直接操作数据库、执行严格的业务规则。这个时候我们就可以整合传统接口应用于大模型。
简单来说,可以分为以下步骤:
- 我们可以把传统应用中的部分功能封装成一个个函数(Function)。
- 然后在提示词中描述用户的需求,并且描述清楚每个函数的作用,要求AI理解用户意图,判断什么时候需要调用哪个函数,并且将任务拆解为多个步骤(Agent)。
- 当AI执行到某一步,需要调用某个函数时,会返回要调用的函数名称、函数需要的参数信息。
- 传统应用接收到这些数据以后,就可以调用本地函数。再把函数执行结果封装为提示词,再次发送给AI。
- 以此类推,逐步执行,直到达成最终结果。
流程如图:
RAG
RAG(Retrieval-Augmented Generation)叫做检索增强生成。简单来说就是把信息检索技术和大模型结合的方案。
大模型从知识角度存在很多限制:
- 时效性差:大模型训练比较耗时,其训练数据都是旧数据,无法实时更新
- 缺少专业领域知识:大模型训练数据都是采集的通用数据,缺少专业数据
现在的大模型都是基于Transformer神经网络,Transformer的强项就是所谓的注意力机制。它可以根据上下文来分析文本含义,所以理解人类意图更加准确。但是,这里上下文的大小是有限制的,GPT3刚刚出来的时候,仅支持2000个token的上下文。现在领先一点的模型支持的上下文数量也不超过 200K token,所以海量知识库数据是无法直接写入提示词的。
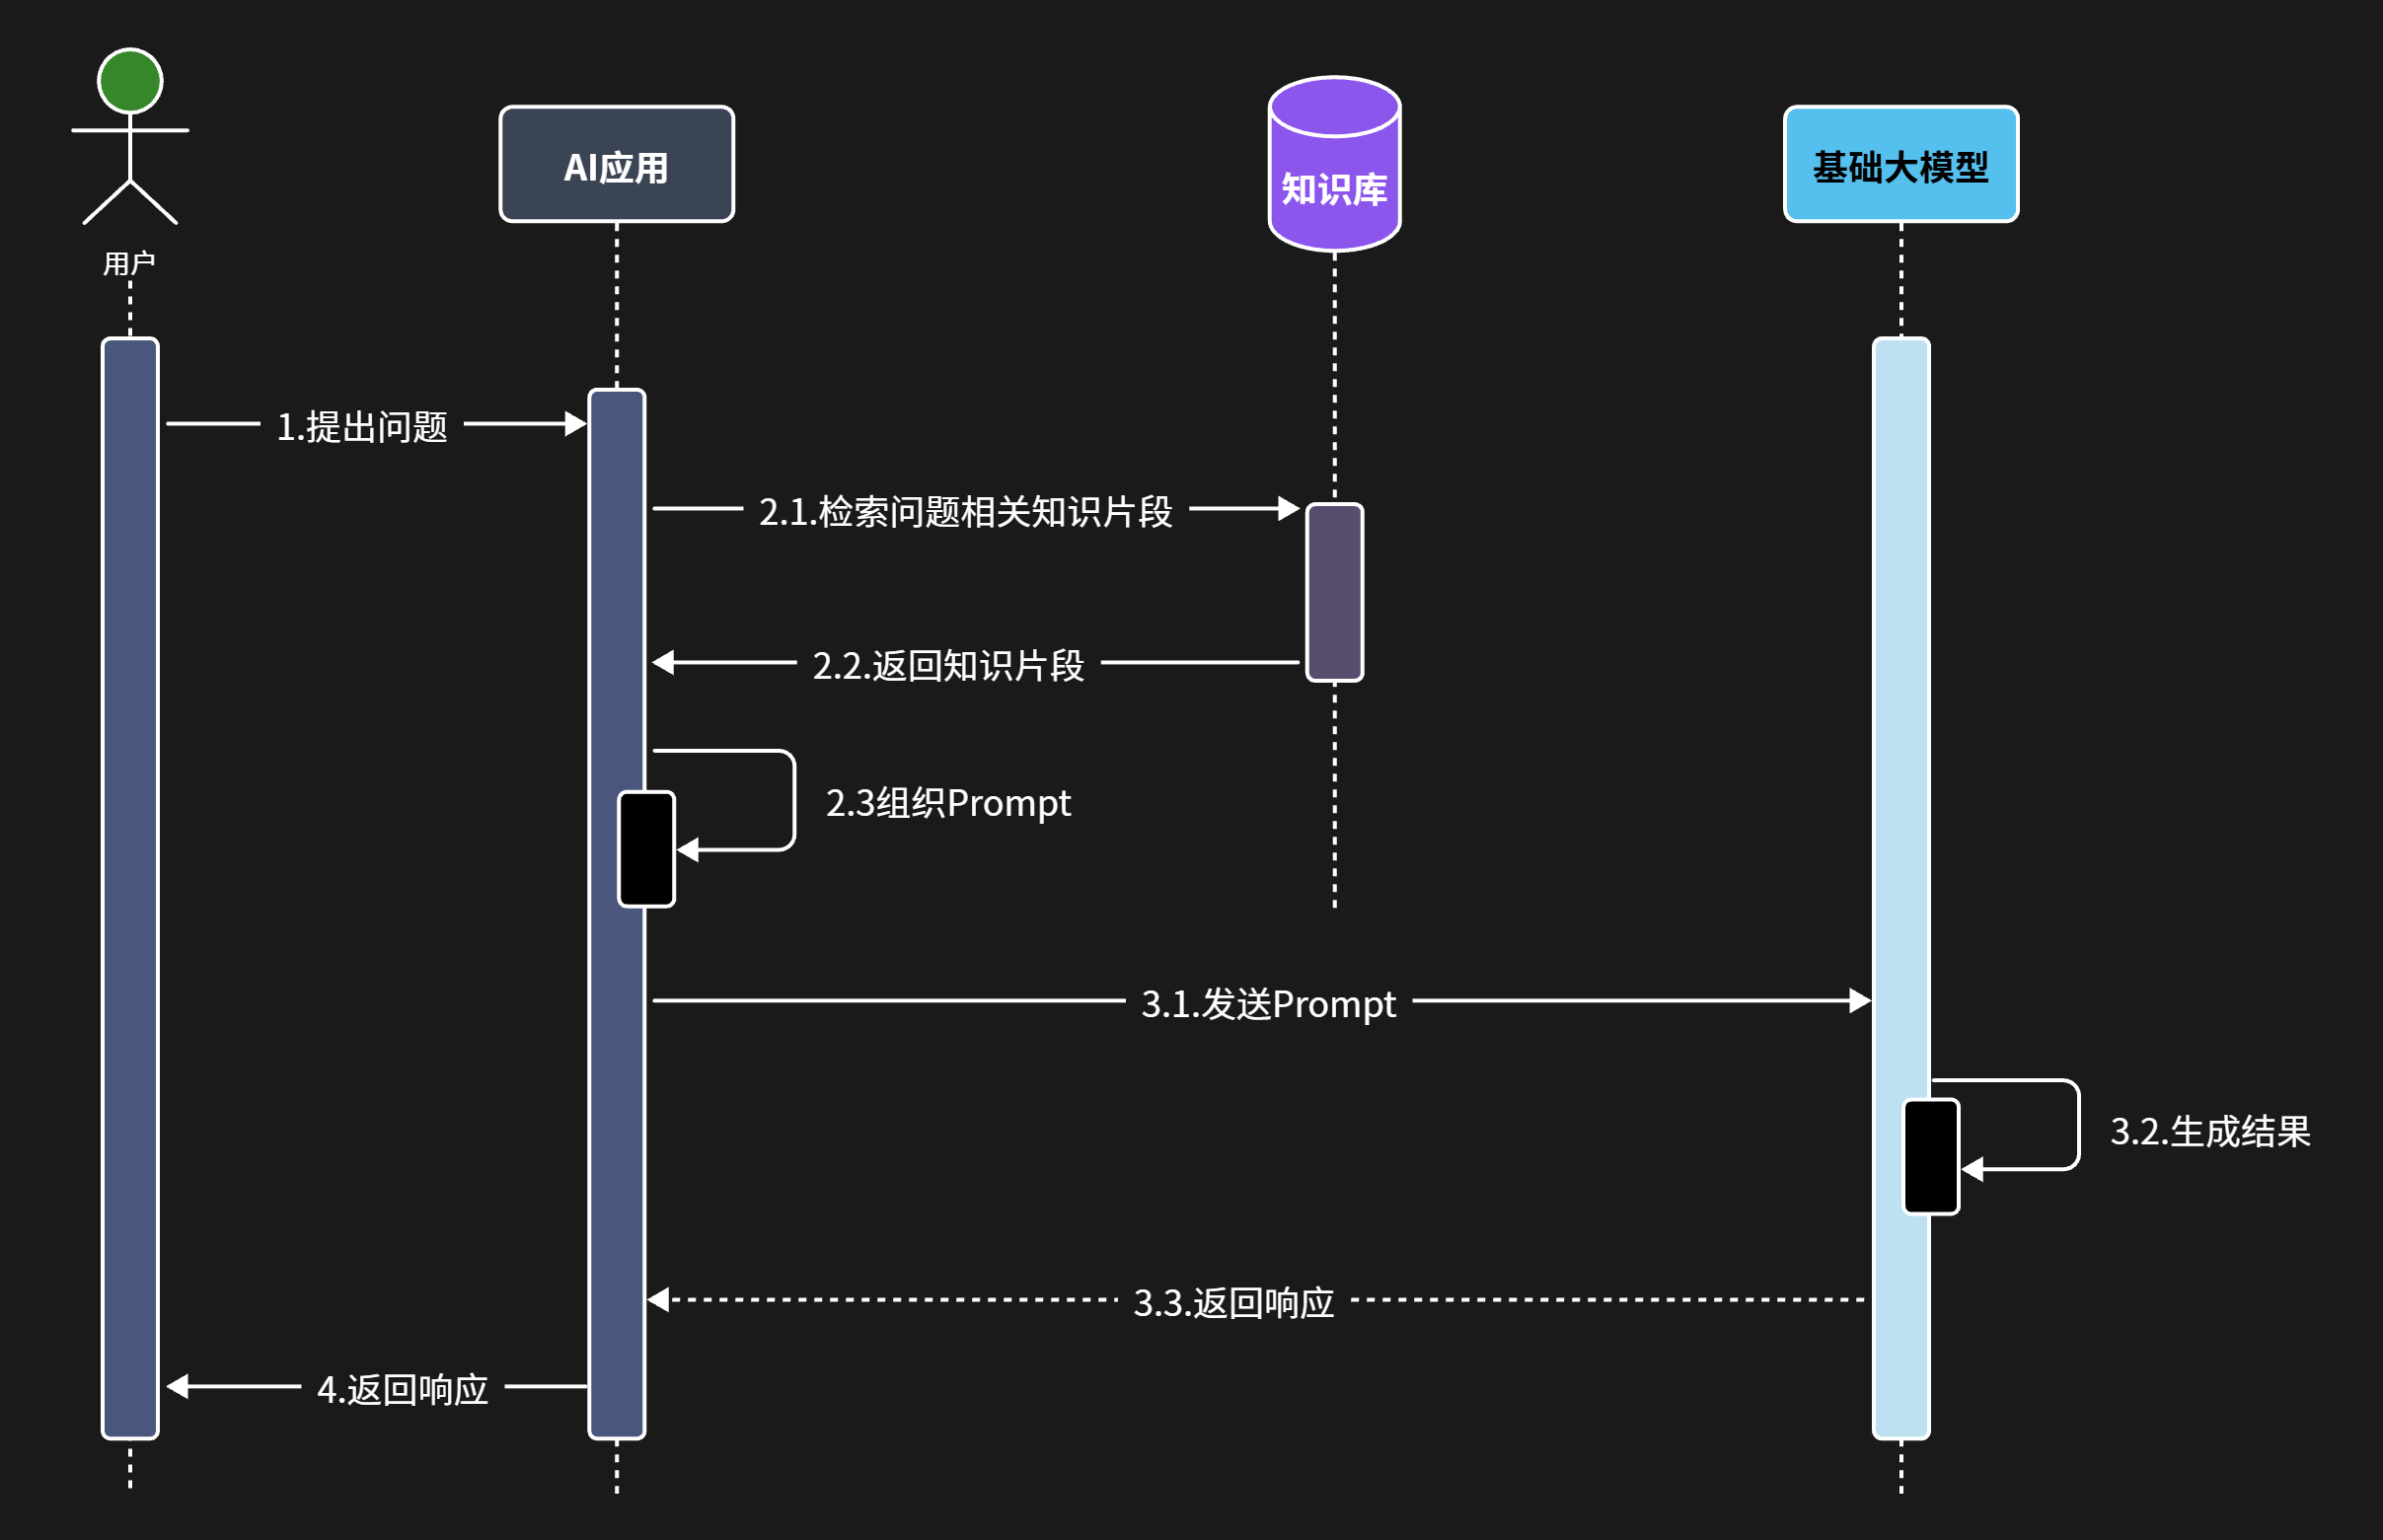
RAG技术正是来解决这一问题的。RAG利用信息检索技术来拓展大模型的知识库,解决大模型的知识限制。整体来说RAG分为两个模块:
- 检索模块(Retrieval):负责存储和检索拓展的知识库
- 文本拆分:将文本按照某种规则拆分为很多片段
- 文本嵌入(Embedding):根据文本片段内容,将文本片段归类存储
- 文本检索:根据用户提问的问题,找出最相关的文本片段
- 生成模块(Generation):
- 组合提示词:将检索到的片段与用户提问组织成提示词,形成更丰富的上下文信息
- 生成结果:调用生成式模型(例如DeepSeek)根据提示词,生成更准确的回答
由于每次都是从向量库中找出与用户问题相关的数据,而不是整个知识库,所以上下文就不会超过大模型的限制,同时又保证了大模型回答问题是基于知识库中的内容。
流程如图:
Fine-tuning
Fine-tuning就是模型微调,就是在预训练大模型(比如DeepSeek、Qwen)的基础上,通过企业自己的数据做进一步的训练,使大模型的回答更符合自己企业的业务需求。这个过程通常需要在模型的参数上进行细微的修改,以达到最佳的性能表现。
在进行微调时,通常会保留模型的大部分结构和参数,只对其中的一小部分进行调整。这样做的好处是可以利用预训练模型已经学习到的知识,同时减少了训练时间和计算资源的消耗。微调的过程包括以下几个关键步骤:
- 选择合适的预训练模型:根据任务的需求,选择一个已经在大量数据上进行过预训练的模型,如Qwen-2.5。
- 准备特定领域的数据集:收集和准备与任务相关的数据集,这些数据将用于微调模型。
- 设置超参数:调整学习率、批次大小、训练轮次等超参数,以确保模型能够有效学习新任务的特征。
- 训练和优化:使用特定任务的数据对模型进行训练,通过前向传播、损失计算、反向传播和权重更新等步骤,不断优化模型的性能。
模型微调虽然更加灵活、强大,但是也存在一些问题:
- 需要大量的计算资源
- 调参复杂性高
- 过拟合风险
系统提示词 (system prompt) 一般有哪些组成部分
一般包含:
- 上下文背景:提供必要信息辅助理解任务场景
- 角色定义:设定模型的身份或职责(如客服、翻译)
- 任务目标:明确需完成的具体任务(如总结、解答问题)
- 输出格式:指定回复的结构或形式(如JSON)
- 约束条件:限制内容长度、语言、安全规范等
- 给出示例:示例很重要,实践表明这对提高输出的准确性非常有帮助
背诵技巧:上局(角)认(任)输约给
第一次世界大战,德国认输,约翰牛(英国)给出议和条件
提示词示例见链接
你的项目中是如何进行文档切分的?为什么这样切分?
在我的项目中,使用 Spring AI 的 PagePdfDocumentReader 进行 PDF 切分,配置是每 1 页 PDF 作为一个 Document:
1 | PagePdfDocumentReader reader = new PagePdfDocumentReader( |
这样设计的原因:
- PDF 的每一页通常是一个相对完整的内容单元
- 页面切分简单高效,适合 PDF 这种有明确分页的文档
- 便于后续按页检索,粒度适中
如果是其他场景,还可以使用:
- 按字符数切分:如每 500 字符切分,适合长文本
- 按语义切分:如按段落、章节切分,保持语义完整性
- 递归切分:先按大粒度切分,超出长度再细分
文档切分粒度对 RAG 效果有什么影响?
切分粒度是 RAG 效果的关键因素,需要 在检索精度和上下文完整性之间权衡:
粒度太细(如按句子):
- 优点:检索精度高,能精准定位
- 缺点:上下文不完整,可能丢失关键信息
粒度太粗(如整个文档):
- 优点:上下文完整
- 缺点:检索精度低,可能引入噪音
你是如何将文档向量化的?用的什么模型?
我使用的是 OpenAI 的 text-embedding-v3 模型,通过 Spring AI 的 OpenAiEmbeddingModel 实现向量化:
1 | spring.ai.openai.embedding.options.model: text-embedding-v3 |
选择这个模型的原因:
- 支持 1024 维度向量,表达能力强
- 阿里云 DashScope 提供 API,国内访问稳定
- 与项目使用的 OpenAI 兼容接口统一,便于维护
向量化的本质:
- Embedding 模型将文本映射到高维向量空间
- 语义相似的文本在向量空间中距离更近
- 支持余弦相似度、欧氏距离等相似度计算
你是如何控制召回质量的?
我通过两个关键参数控制召回质量:
1 | SearchRequest request = SearchRequest.builder() |
参数说明:
topK:返回相似度最高的 K 个文档- 太小:可能遗漏关键信息
- 太大:引入噪音,增加 LLM 处理负担
- 我的配置:topK=2,适合单轮问答
similarityThreshold:相似度阈值- 过滤掉相似度低于阈值的结果
- 我的配置:0.6,低于 60% 相似度的结果不返回
- 需要根据实际效果调优
filterExpression:元数据过滤- 支持按文件名、会话 ID 等元数据过滤
- 避免不同文档的向量互相干扰
如果召回效果不好,你会怎么优化?
我会从以下几个方面优化:
- 调整切分策略:尝试不同的切分粒度(如从按页切分改为按段落),增加重叠区域(overlap)
- 优化 Embedding 模型:尝试领域微调过的 Embedding 模型,如 BGE、M3E 等中文优化模型
- 调整检索参数:降低
similarityThreshold,增加召回量,增加 topK,但配合 rerank 模型二次排序 - 引入 Rerank 模型:先用 Embedding 粗筛,再用 Rerank 模型精排,如 Cohere Rerank、BGE Reranker
- Query 改写:使用 LLM 对用户问题进行扩展或改写,生成多个子查询,分别检索后合并结果
- 混合检索:结合向量检索和关键词检索(BM25),提高召回的多样性
检索到的文档是如何传递给 LLM 的?
Spring AI 通过 QuestionAnswerAdvisor 自动完成上下文拼接:
1 |
|
工作流程:
- QuestionAnswerAdvisor 是一个环绕增强器(Advisor)
- 在用户提问前,自动触发向量检索
- 将检索到的文档拼接到 System Prompt 中
- LLM 基于上下文生成回答
- 通过 filterExpression 控制只使用特定文件的上下文
实际生成的 Prompt 类似:
1 | 请根据上下文回答问题,遇到上下文没有的问题,不要随意编造. |
背诵技巧:挑(调)一(Embedding)件(检)
如果上下文太长,超过了 LLM 的上下文窗口怎么办?
- 限制 topK:只返回最相关的 2 个文档,避免上下文过长
- 设置相似度阈值:过滤掉低相关度的文档
- 如果仍然超长,可以考虑:
- 压缩上下文:使用 LLM 对检索结果做摘要
- 滑动窗口:只保留最近 N 轮对话的上下文
- 使用长上下文模型:如 DeepSeek V4 Flash
你的项目中 RAG 的应用场景是什么?
我的项目实现了一个 PDF 智能问答系统,主要场景包括:
- 用户上传 PDF:通过 /ai/pdf/upload/{chatId} 接口上传
- 文档向量化:自动解析 PDF 并存入 Elasticsearch
- 智能问答:用户提问时,从 PDF 中检索相关内容并生成回答
- 多会话隔离:通过 chat_id 元数据实现不同会话的文档隔离
遇到什么挑战?怎么解决的?
- 挑战 1:向量检索精度不高
- 问题:返回的文档与问题相关性低
- 解决:
- 调整相似度阈值从 0.5 提高到 0.6
- 优化切分粒度,保持语义完整性
- 挑战 2:多文档管理混乱
- 问题:不同用户的文档向量互相干扰
- 解决:通过 filterExpression 按 chat_id 过滤
请介绍一下 Spring AI 框架?你为什么使用它?
Spring AI 是 Spring 官方推出的 AI 应用开发框架,提供了一套统一的抽象层来对接各种 AI 服务。它的核心优势包括:
- 丰富的功能支持:
- 对话模型(Chat)
- 文本向量化(Embedding)
- 向量数据库(VectorStore)
- 对话记忆(ChatMemory)
- RAG、Function Calling 等高级特性
- 统一的抽象接口:
- 通过 ChatModel、EmbeddingModel、VectorStore 等接口统一不同厂商的 API
- 切换模型提供商时只需修改配置,无需改动代码
- 与 Spring 生态无缝集成:
- 支持 Spring Boot 自动配置
- 依赖注入、AOP 等特性开箱即用
- 与 Spring Data、Spring Security 等无缝集成
在我的项目中,我使用 Spring AI 对接了:
- OpenAI(阿里云 DashScope):对话模型和 Embedding 模型
- Elasticsearch:向量数据库
- Ollama:本地模型(可选)
Spring AI 的核心组件有哪些?
Spring AI 的核心组件包括:
- ChatModel(对话模型):
- 用于与大语言模型交互
- 实现类:OpenAiChatModel、OllamaChatModel 等
- 支持同步和流式响应
- EmbeddingModel(向量化模型):
- 将文本转换为向量
- 实现类:OpenAiEmbeddingModel
- 用于 RAG 场景
- VectorStore(向量数据库):
- 存储和检索向量数据
- 实现类:ElasticsearchVectorStore、SimpleVectorStore 等
- 支持相似度搜索
- ChatMemory(对话记忆):
- 管理对话历史
- 实现类:MessageWindowChatMemory
- 支持多轮对话
- ChatClient(对话客户端):
- 高级抽象,封装了完整的对话流程
- 支持 Advisor(增强器)机制
- 类似 Spring MVC 的 RestClient
- Advisor(增强器):
- AOP 思想的体现
- 实现日志记录、记忆管理、RAG 等功能
- 如 SimpleLoggerAdvisor、MessageChatMemoryAdvisor、QuestionAnswerAdvisor
你是如何使用 Spring AI 对接大模型的?
我通过 Spring AI 的 ChatClient 对接大模型,配置如下:
application.yaml:
1 | spring.ai.openai: |
配置类:
1 |
|
使用方式:
1 |
|
优势:
- 通过 ChatClient 封装,业务代码无需关心底层模型调用
- 通过 Advisor 机制实现功能增强,解耦性强
- 切换模型只需修改配置,无需改动代码
如果要切换模型提供商,需要改代码吗?
不需要改代码,这正是 Spring AI 的优势所在,只需要修改配置
你是如何使用 Embedding 模型的?
我使用 Spring AI 的 OpenAiEmbeddingModel 进行文本向量化:
配置:
1 | spring.ai.openai.embedding: |
使用方式:
1 |
|
实际应用场景:
- 在 RAG 场景中,QuestionAnswerAdvisor 会自动调用 模型
- 用户提问 → 向量化 → 向量数据库检索 → 返回相似文档
底层原理:
- Spring AI 将文本发送到 OpenAI 兼容的 API
- API 返回 1024 维的浮点数组
- 向量归一化后存入 Elasticsearch
你是如何使用向量数据库的?为什么选择 Elasticsearch?
我使用 Spring AI 的 ElasticsearchVectorStore 作为向量数据库:
配置:
1 | spring.ai.vectorstore.elasticsearch: |
使用方式:
1 |
|
选择 Elasticsearch 的原因:
- 功能强大:支持向量检索 + 全文检索,可以混合查询
- 生态成熟:Spring Data Elasticsearch 支持完善
- 可扩展性:支持分布式部署,适合生产环境
- 团队熟悉:团队已有 ES 使用经验
你是如何实现多轮对话记忆的?
我使用 Spring AI 的 ChatMemory 机制实现多轮对话:
配置类:
1 |
|
使用方式:
1 |
|
工作原理:
- 每个 chatId 对应一个独立的对话历史
- MessageChatMemoryAdvisor 在请求前自动加载历史
- 响应后自动保存当前对话
- 超过 maxMessages 时自动淘汰旧消息
请解释一下 Spring AI 的 Advisor 机制?
Advisor 是 Spring AI 的核心设计模式,体现了 AOP(面向切面编程)思想:
核心概念:
- Advisor 是环绕增强器,可以在请求前后插入逻辑
- 多个 Advisor 可以链式组合,形成责任链
- 通过 defaultAdvisors() 注册到 ChatClient
常用的 Advisor:
- SimpleLoggerAdvisor:记录请求和响应的日志
- MessageChatMemoryAdvisor:管理对话记忆
- QuestionAnswerAdvisor:实现 RAG 检索增强
- SafeGuardAdvisor:内容安全审查(暂时未用到)
项目中的使用:
1 |
|
执行顺序:
用户请求 → Logger → Memory → RAG → LLM → RAG → Memory → Logger → 响应
请描述一下你的项目中 Spring AI 的完整使用流程?
以 PDF 智能问答为例,完整流程如下:
配置阶段:
1 | // 模型配置 |
初始化阶段:
1 |
|
文档上传与向量化:
1 | // FileServiceImpl.java |
智能问答:
1 | // PdfController.java |
执行流程:
用户提问 → Logger 记录 → Memory 加载历史 → RAG 检索文档 → 拼接上下文 → LLM 生成回答 → RAG 返回 → Memory 保存 → Logger 记录 → 流式响应